700 pages of specifications, zero test cases, and a new distribution center that needs testing. Aleksandar Toskovic (Migros Online) and Nina Schweigert (Xebia) show at Swiss Testing Day 2026 how they used a custom-built AI Factory to generate usable User Acceptance Tests from mammoth documentation — and why “user story” was the magic word.
Key Takeaways
- From 20,000 to 400 test cases: Three iterative runs with different chunking and prompting reduced the set to a usable size. The key was switching from “requirements” to “user stories” in the prompt
- 60% accuracy is enough as a starting point: An imperfect test case is easier to correct than a blank page. The generated tests were the “absolute enabler” for 30-40 testers
- Six document challenges solved: Chunking, glossary resolution, cross-references, images, tables, strikethrough text, each problem needed its own preprocessing solution
- LLMs completely ignore formatting: Bold, italic, strikethrough: all treated as normal text. This had real consequences in the project
- The prompt makes the difference: “Search for requirements” produced 20,000 overly detailed test cases. “Search for user stories” delivered 400 at the right level
The Starting Point: A Warehouse Without Test Cases
Migros Online — as old as Google, for context — delivers groceries to homes. To serve more customers, the company is modernizing its distribution centers: high-bay warehouses up to 14 meters, shuttle robots, automated picking using the “goods-to-person” principle, automated outbound buffer, rail delivery for ecological footprint. 210,000 meters of cable for communication between all systems.
The problem: the entire specification covers nearly 700 pages of process documentation and 150 pages of IT specification, but no test cases. They forgot to write them during the specification phase. For user acceptance testing of the new facility, they are desperately needed.
The two options at Migros Online: hire people to read 700 pages again — or generate the test cases with AI.
Six Challenges, Six Solutions
Nina Schweigert (Xebia) built the PoC and then the AI Factory. The challenges were significant:
1. Document size: 300,000+ tokens, GPT context window at 128,000. Solution: chunking by chapters and subchapters (167 text fragments). Built a knowledge base from these, generated answers via RAG.
2. Glossary and abbreviations: Definitions sit at the end of the document, not where the abbreviation appears. Solution: preprocessing; embedding explanations directly into the respective chunk.
3. Cross-references: Massive, within and between documents. Solution: metadata enrichment in preprocessing; which chunk references which other chunk.
4. Images: Architecture sketches and BPMs were simply invisible to the 2024 LLM. Solution: get images delivered as separate files, generate text descriptions via LLM, store in knowledge base.
5. Tables: The LLM ignored table structure and read line by line with absurd results. Solution: extract tables, convert to markup, store as such.
6. Strikethrough text: LLMs ignore all text formatting. Strikethrough chapters and sentences were treated as normal text. Solution: no glorious solution, but manual search and removal.
“LLMs don’t react to text formatting at all — whether bold, italic, or strikethrough. The painful experience was also had by American courts with the redacted texts from the Epstein files.” — Nina Schweigert
The AI Factory: Four-Step Pipeline
The knowledge base was only a small part of the whole. The workflow:
- Per subchapter (167 total): extract requirements
- Validate requirements: are they actually present in the text fragment?
- For each validated requirement: generate test cases
- Validate test cases
Plus human in the loop: Aleksandar regularly did spot checks and could reject hallucinations. A run across all 167 fragments took up to 24 hours.
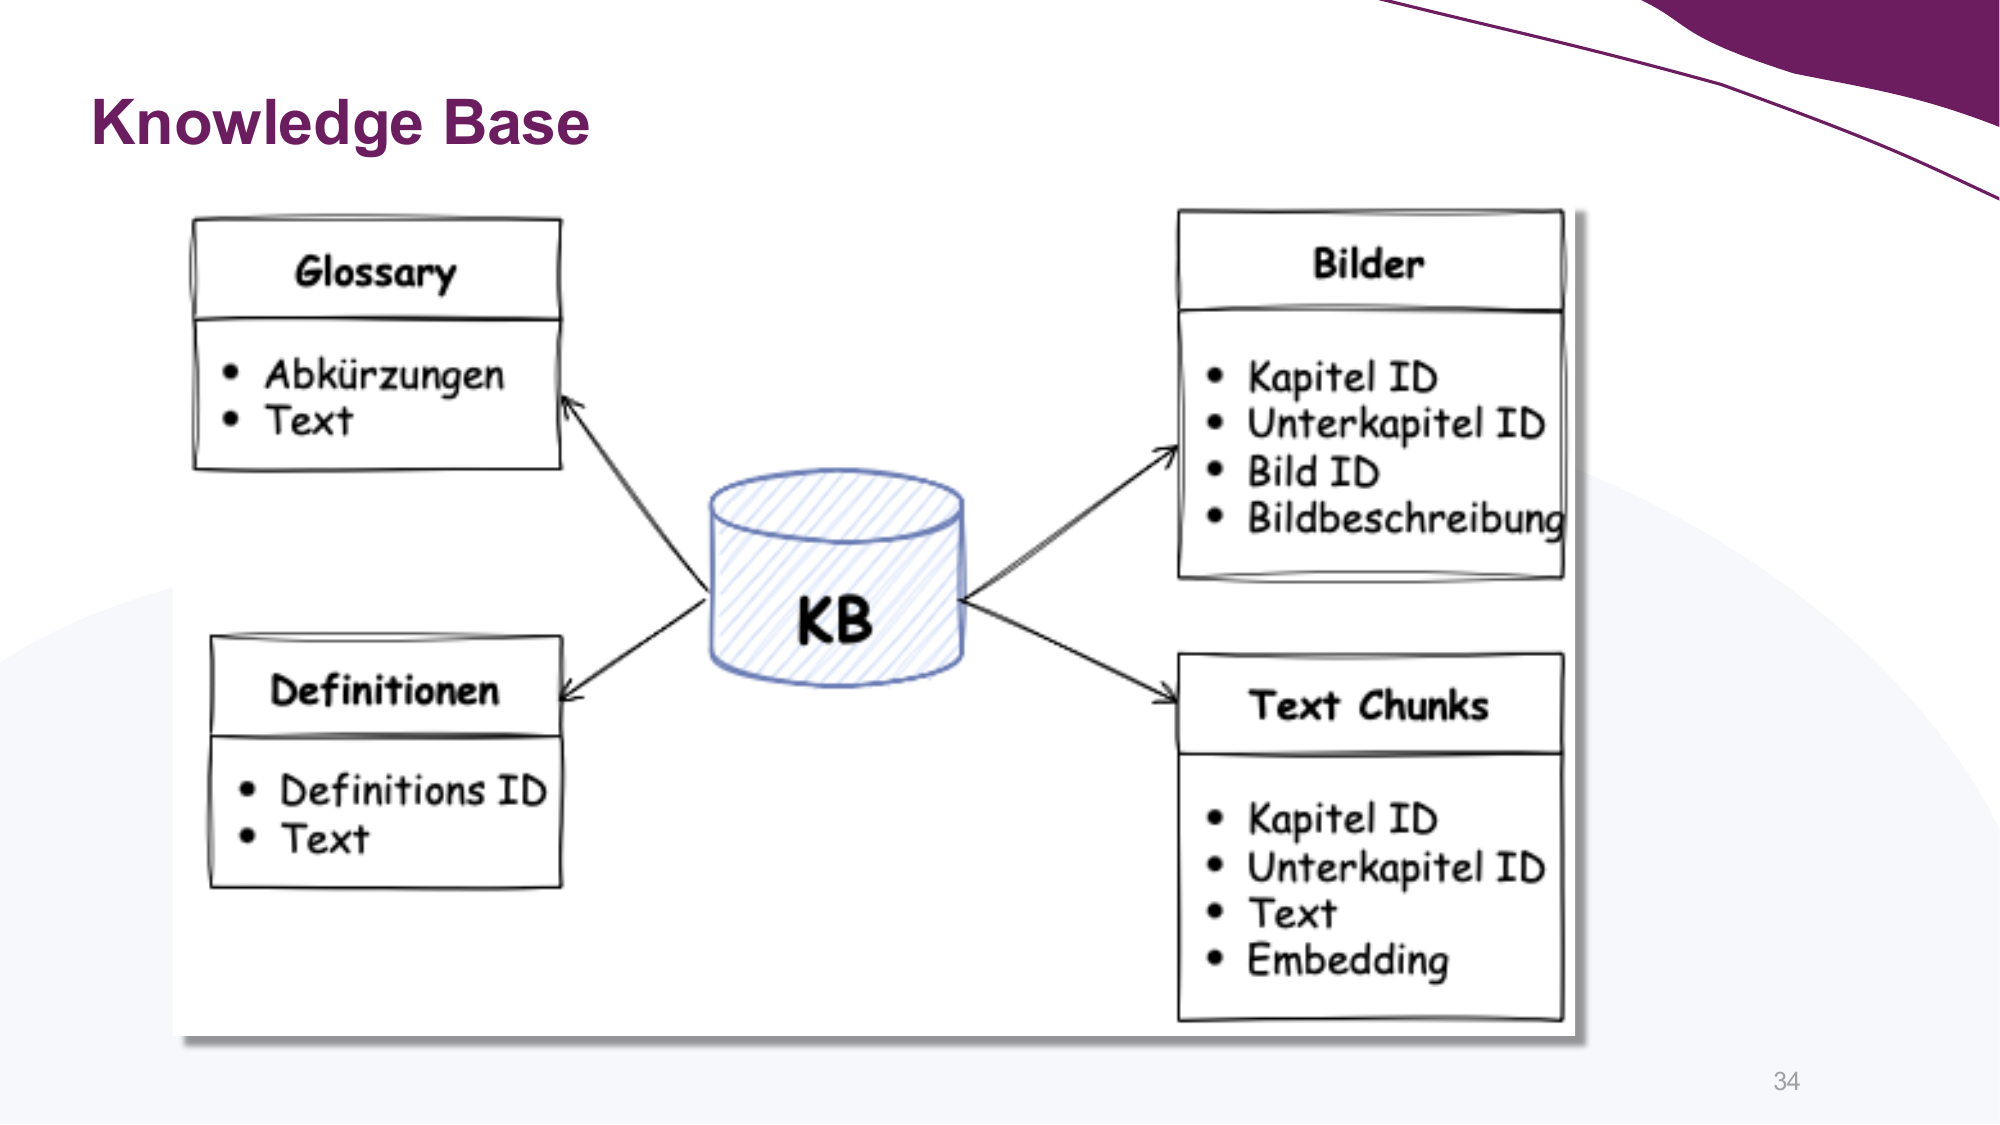 The knowledge base: glossary definitions, image descriptions, tables as markup, and text chunks — all with metadata for the RAG pipeline.
Three Runs, One Magic Word
Run 1 — 20,000 test cases: Correct, but far too detailed for user acceptance tests. Not suitable.
Run 2 — 8,000 test cases: Larger chunks (whole chapter instead of subchapter). Better altitude, but still too detailed, with overlaps.
Run 3 — 400 test cases: The prompt was changed: instead of “search for requirements,” now “search for user stories.” That was the breakthrough.
“Suddenly we got 400 test cases. We took those — the altitude was right.” — Aleksandar Toskovic
The user story context meant that warehouse workers who had to test understood what to do — because the user stories describe their future work.
Lessons Learned: 60% Is Enough as a Starting Point
After review, overall accuracy was about 60% rather than the targeted 80%. Yet the conclusion was clear:
“If I put something in front of people — even if it’s not 100% correct — it’s still easier to correct it than for anyone to have started creating a test case from scratch.” — Aleksandar Toskovic
Testers corrected during review: splitting one test case into three, combining two into one. The generated test cases were the “absolute enabler” for 30-40 people who needed to test 700 pages following the same pattern.
The bottom line: 60% accuracy, but the decisive enabler. Correcting a test case is easier than creating one.
What Does This Mean for Your Team?
- An imperfect output beats a blank page: 60% accuracy sounds low, but the enabler effect for 30+ testers was enormous. Start with “good enough” and iterate.
- Prompt wording is decisive: “Requirements” vs. “user stories” made the difference between 20,000 and 400 test cases. Experiment with language.
- Preprocessing is the main effort: The actual AI generation is the smaller part. Document preparation (chunking, glossary, cross-references, images, tables) dominates.
- Human in the loop is not optional: Spot checks, validation, rejection of hallucinations. The combination of automated generation and human review delivers the result.
- Define test cases upfront in future: The biggest lesson: in new projects, write test cases during the specification phase, ideally as user stories.
Speakers
Aleksandar Toskovic — Manager IT Logistics Infrastructure Projects at Migros Online, responsible for testing of the new automated distribution center. Hands-on experience integrating AI-generated test cases into user acceptance testing with 30-40 testers.
Nina Schweigert — Senior Expert Consultant & AI Ambassador at Xebia, built the PoC and AI Factory for automated test case generation. Expertise in LLM-based document preprocessing and RAG architectures.
Dude, where’s my Test Case? Wie Migros Online aus 700 Seiten Dokumentation 400 Testfälle generierte
700 Seiten Spezifikation, null Testfälle, und ein neues Verteilzentrum, das getestet werden muss. Aleksandar Toskovic (Migros Online) und Nina Schweigert (Xebia) zeigen am Swiss Testing Day 2026, wie sie mit einer selbstgebauten AI Factory aus einer Mammut-Dokumentation brauchbare User Acceptance Tests generierten — und warum “User Story” das Zauberwort war.
Key Takeaways
- Von 20.000 auf 400 Testfälle: Drei iterative Durchläufe mit unterschiedlichem Chunking und Prompting reduzierten die Menge auf ein brauchbares Set. Der Schlüssel war der Wechsel von “Anforderungen” zu “User Stories” im Prompt
- 60 % Genauigkeit reicht als Startpunkt: Ein imperfekter Testfall ist einfacher zu korrigieren als ein leeres Blatt. Die generierten Tests waren der “absolute Enabler” für 30-40 Tester
- Sechs Dokumenten-Challenges gelöst: Chunking, Glossar-Auflösung, Querverweise, Bilder, Tabellen, durchgestrichener Text; jedes Problem brauchte eine eigene Preprocessing-Lösung
- LLMs ignorieren Formatierung komplett: Bold, Italic, Durchgestrichen: alles wie normaler Text. Das hatte im Projekt reale Konsequenzen
- Der Prompt macht den Unterschied: “Suche Anforderungen” produzierte 20.000 zu detaillierte Testfälle. “Suche User Stories” lieferte 400 auf der richtigen Flughöhe
Die Ausgangslage: Ein Lager ohne Testfälle
Migros Online — so alt wie Google, zur Einordnung — liefert Lebensmittel nach Hause. Um mehr Kunden bedienen zu können, modernisiert das Unternehmen seine Verteilzentren: Hochregallager bis 14 Meter, Shuttle-Roboter, automatisiertes Picking nach dem Prinzip “Ware kommt zur Person statt Person zur Ware”, automatisierter Warenausgangspuffer, Bahnbelieferung für den ökologischen Fußabdruck. 210.000 Meter Kabel für die Kommunikation zwischen allen Systemen.
Das Problem: Die gesamte Spezifikation umfasst fast 700 Seiten Prozessdokumentation und 150 Seiten IT-Spezifikation aber keine Testfälle. Es wurde versäumt, sie bei der Spezifikation mitzuschreiben. Für den User Acceptance Test der neuen Anlage braucht man sie aber dringend.
Die zwei Optionen bei Migros Online: Leute einstellen, die 700 Seiten nochmals lesen — oder die Testfälle maschinell erstellen lassen.
Sechs Challenges, Sechs Lösungen
Nina Schweigert (Xebia) baute den PoC und dann die AI Factory. Die Herausforderungen waren erheblich:
1. Dokumentgröße: 300.000+ Tokens, GPT Context Window bei 128.000. Lösung: Chunking nach Kapiteln und Unterkapiteln (167 Textfragmente). Daraus eine Knowledge Base aufgebaut, Antworten via RAG generiert.
2. Glossar und Abkürzungen: Definitionen stehen am Dokumentende, nicht beim Text. Lösung: Preprocessing; Erläuterungen direkt in den jeweiligen Chunk eingebettet.
3. Querverweise: Massenhaft, innerhalb und zwischen Dokumenten. Lösung: Metadaten-Anreicherung im Preprocessing; welcher Chunk auf welchen anderen verweist.
4. Bilder: Architekturskizzen und BPMs waren für die LLM von 2024 schlicht unsichtbar. Lösung: Bilder separat als Dateien liefern lassen, per LLM Textbeschreibungen generieren, in der Knowledge Base speichern.
5. Tabellen: Die LLM ignorierte die Tabellenstruktur und las Zeile für Zeile mit absurdem Ergebnis. Lösung: Tabellen extrahieren, in Markup umwandeln und als solches speichern.
6. Durchgestrichener Text: LLMs ignorieren jede Textformatierung. Durchgestrichene Kapitel und Sätze wurden wie normaler Text behandelt. Lösung: Keine gloriose Lösung. Händisch suchen und rausnehmen.
“LLMs reagieren überhaupt nicht auf Textformatierungen — egal ob bold, italic oder durchgestrichen. Die leidige Erfahrung mussten auch die amerikanischen Gerichte mit den geschwärzten Texten aus den Epstein-Fällen machen.” — Nina Schweigert
Die AI Factory: Pipeline in vier Schritten
Die Knowledge Base war nur ein kleiner Teil des Ganzen. Der Workflow:
- Pro Unterkapitel (167 Stück): Anforderungen extrahieren
- Anforderungen validieren: Sind sie wirklich im Textfragment vorhanden?
- Zu jeder validierten Anforderung: Testfälle erstellen
- Testfälle validieren
Plus Human in the Loop: Aleksandar machte regelmäßig Spotchecks und konnte Halluzinationen zurückweisen. Ein Durchlauf über alle 167 Fragmente dauerte bis zu 24 Stunden.
Die Knowledge Base: Glossar-Definitionen, Bildbeschreibungen, Tabellen als Markup und Text-Chunks — alle mit Metadaten für die RAG-Pipeline.
Drei Durchläufe, ein Zauberwort
Durchlauf 1 — 20.000 Testfälle: Korrekt, aber viel zu detailliert für User Acceptance Tests. Nicht geeignet.
Durchlauf 2 — 8.000 Testfälle: Größere Chunks (ganzes Kapitel statt Unterkapitel). Bessere Flughöhe, aber immer noch zu detailliert, mit Überschneidungen.
Durchlauf 3 — 400 Testfälle: Der Prompt wurde geändert: statt “Suche Anforderungen” nun “Suche User Stories.” Das war der Durchbruch.
“Da sind wir plötzlich auf 400 Testfälle gekommen. Die haben wir genommen, da war auch die Flughöhe gut.” — Aleksandar Toskovic
Der User-Story-Kontext bewirkte, dass die Lager-Mitarbeitenden, die testen mussten, verstanden, was zu tun ist. Weil die User Stories ihre zukünftige Arbeit beschreiben.
Lessons Learned: 60 % reichen als Startpunkt
Nach dem Review lag die Gesamtgenauigkeit bei etwa 60 % statt der angepeilten 80 %. Trotzdem war das Fazit eindeutig:
“Wenn ich was hinstelle — und das ist nicht mal 100 % richtig — ist es immer noch einfacher, das zu korrigieren, als dass irgendjemand angefangen hätte, einen Testfall zu erstellen.” — Aleksandar Toskovic
Die Tester haben während dem Reviewing gleich korrigiert: aus einem Testfall drei gemacht, aus zweien einen kombiniert. Die generierten Testfälle waren der “absolute Enabler” für 30-40 Personen, die nach dem gleichen Muster 700 Seiten testen mussten.
Die Bilanz: 60 % Genauigkeit, aber der entscheidende Enabler. Einen Testfall zu korrigieren ist einfacher, als einen zu erstellen.
Was bedeutet das für Ihr Team?
- Ein imperfekter Output schlägt ein leeres Blatt: 60 % Genauigkeit klingt niedrig, aber der Enabler-Effekt für 30+ Tester war enorm. Starten Sie lieber mit “gut genug” und iterieren.
- Prompt-Wording ist entscheidend: “Anforderungen” vs. “User Stories” machte den Unterschied zwischen 20.000 und 400 Testfällen. Experimentieren Sie mit der Sprache.
- Preprocessing ist der Hauptaufwand: Die eigentliche AI-Generierung ist der kleinere Teil. Dokumentaufbereitung — Chunking, Glossar, Querverweise, Bilder, Tabellen — dominiert.
- Human in the Loop ist nicht optional: Spotchecks, Validierung, Zurückweisung bei Halluzinationen. Die Kombination aus automatisierter Generierung und menschlichem Review liefert das Ergebnis.
- Definieren Sie Testfälle künftig vorab: Die größte Lesson: Bei neuen Projekten Testfälle direkt bei der Spezifikation mitschreiben — idealerweise als User Stories.
Speaker
Aleksandar Toskovic — Manager IT Logistics Infrastructure Projects bei Migros Online, verantwortlich für das Testing des neuen automatisierten Verteilzentrums. Praxiserfahrung mit der Integration von AI-generierten Testfällen in den User Acceptance Test mit 30-40 Testern.
Nina Schweigert — Senior Expert Consultant & AI Ambassador bei Xebia, Aufbau des PoC und der AI Factory für die automatisierte Testfall-Generierung. Expertise in LLM-basiertem Dokumenten-Preprocessing und RAG-Architekturen.
Dieser Beitrag basiert auf der Session “Dude, where’s my Test Case? Wie LLMs die Testfall-Erstellung bei Migros Online revolutionieren” am Swiss Testing Day 2026, 26. März 2026, StageOne Zürich. Konferenz-Motto: “Defining Quality in a Dangerous Decade.”