Speaker: Ezgi Berberoglu (SW Engineer in Test) | Swiss Testing Day 2026 | Room 5, 10:00
Key Takeaways
- Trust, not speed, is the central problem—AI can be both convincing and wrong at the same time. Without an evidence gate, plausible suggestions become risky actions.
- Deterministic policy gates before AI recommendations—A rule-based gate decides, based on risk levels, whether the AI is allowed to act before an AI recommendation is even generated.
- Structured evidence dramatically improves AI quality—useful advice increases from 35% to 53%, and unsubstantiated claims decrease from 21% to 4% when processed evidence records are used instead of raw CI logs.
Making AI Advice Trustworthy in Test Failure Triage
Picture this: a test fails, and AI suggests “Likely flaky — quarantine the test to unblock CI.” Sounds plausible, turns the pipeline green — but does it solve the problem? At Swiss Testing Day 2026, Ezgi Berberoglu, SW Engineer in Test, presented a systematic approach to answering exactly this question.
The Core Problem: Trust Over Speed
“I’m not really interested in how to speed up execution, but rather making decisions around failures trustworthy.”
AI can help enormously with failure analysis — clustering failures, suggesting next steps, summarizing results. But faster output does not automatically mean safer decisions. The real risk: AI can be confident and wrong at the same time. Under time pressure, teams accept AI suggestions, the pipeline goes green — but the root cause stays hidden.
Berberoglu frames this as “speed with drift” versus “speed with accountability.” Without a systematic check, plausible AI advice becomes risky action.
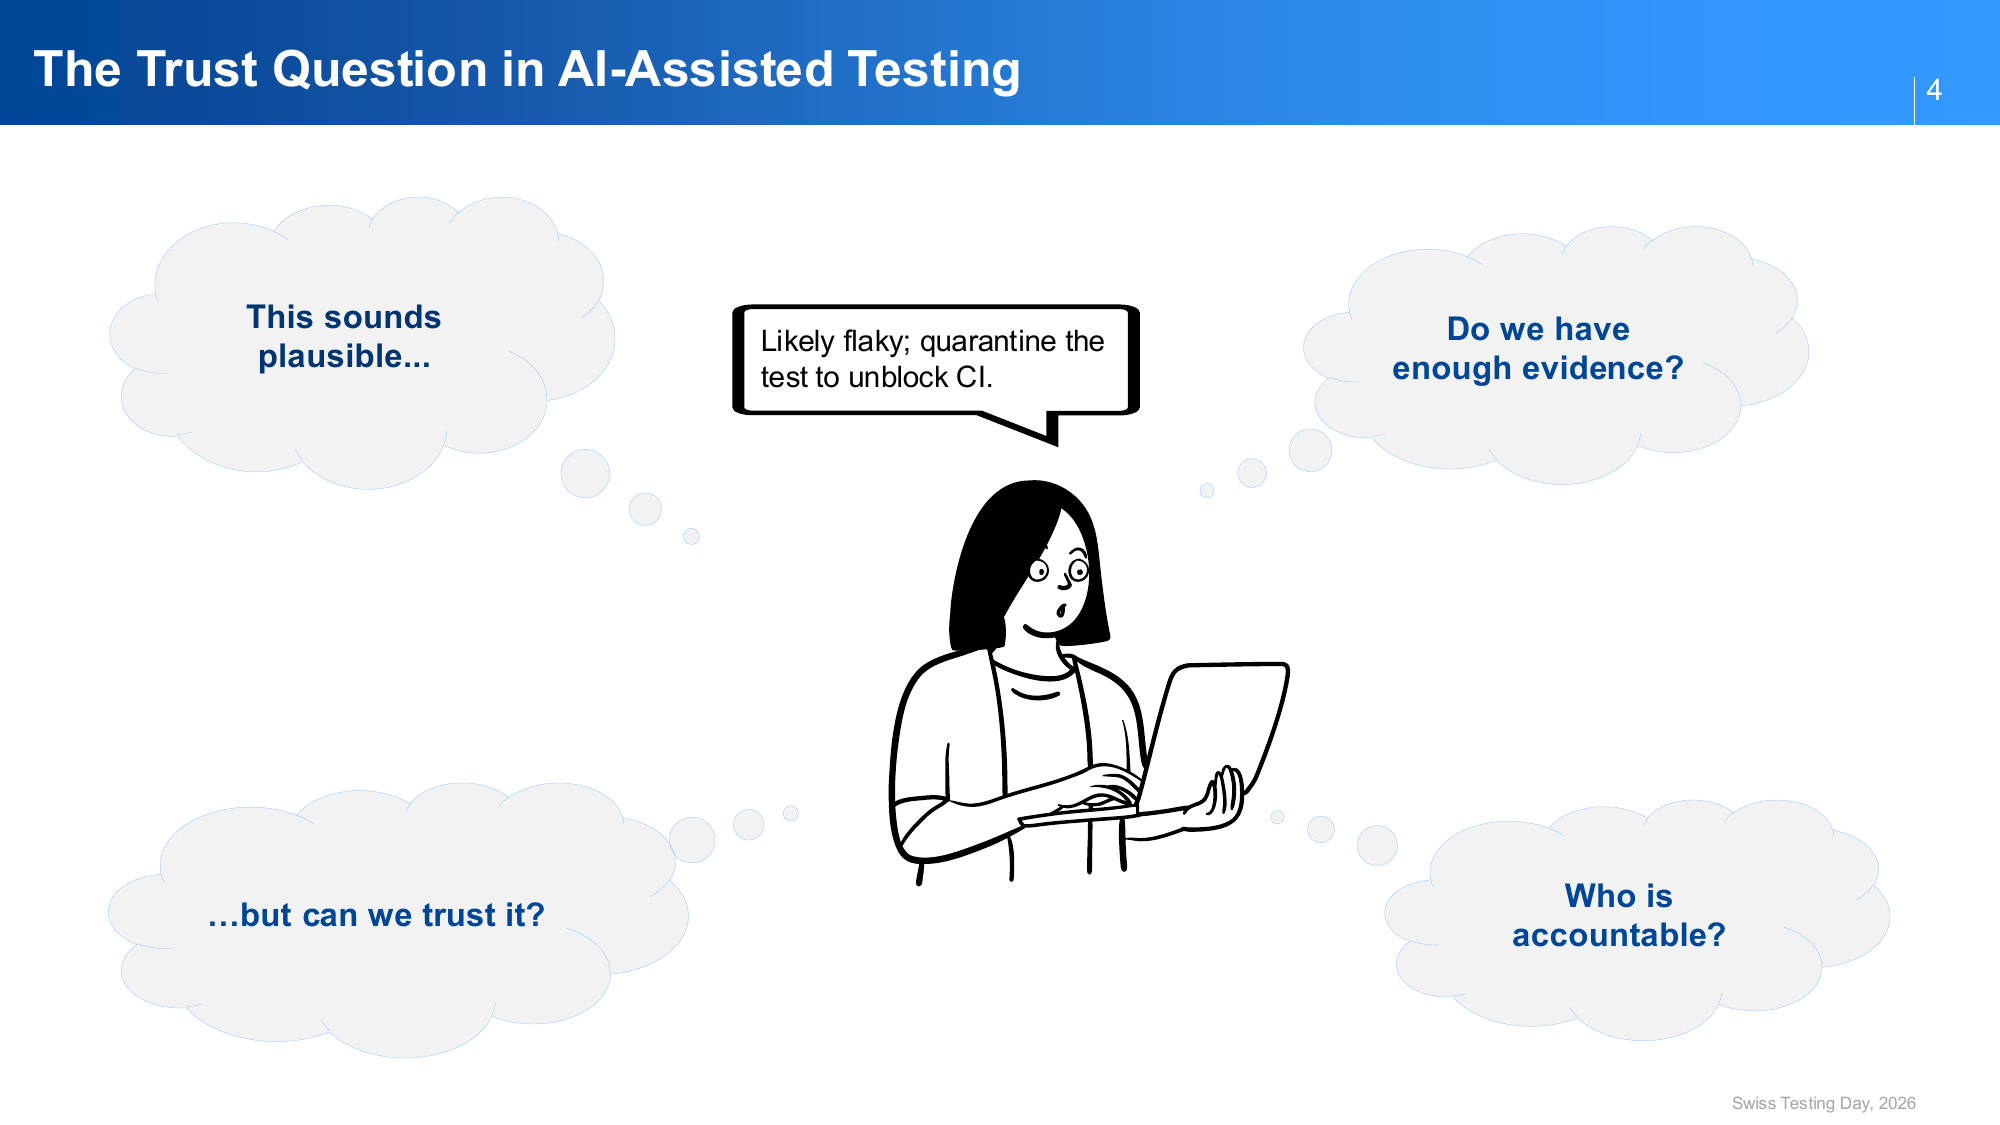
The key question of trust: It sounds plausible—but can we prove it? Who is responsible?
The Solution: A Deterministic Policy Gate
The approach places AI deliberately last in a three-stage pipeline:
- Extract evidence anchors — From failing CI logs, systematically extract test names, error types, error messages, and failure scope using deterministic rules (regex, pattern matching).
- The gate decides — Rule-based, no AI involved. Based on evidence quality and failure signals, a risk level is assigned (Low, Medium, High).
- AI advises — Only then does AI receive the structured evidence records (not raw logs!) and provide a bounded proposal attached to the audit trace.
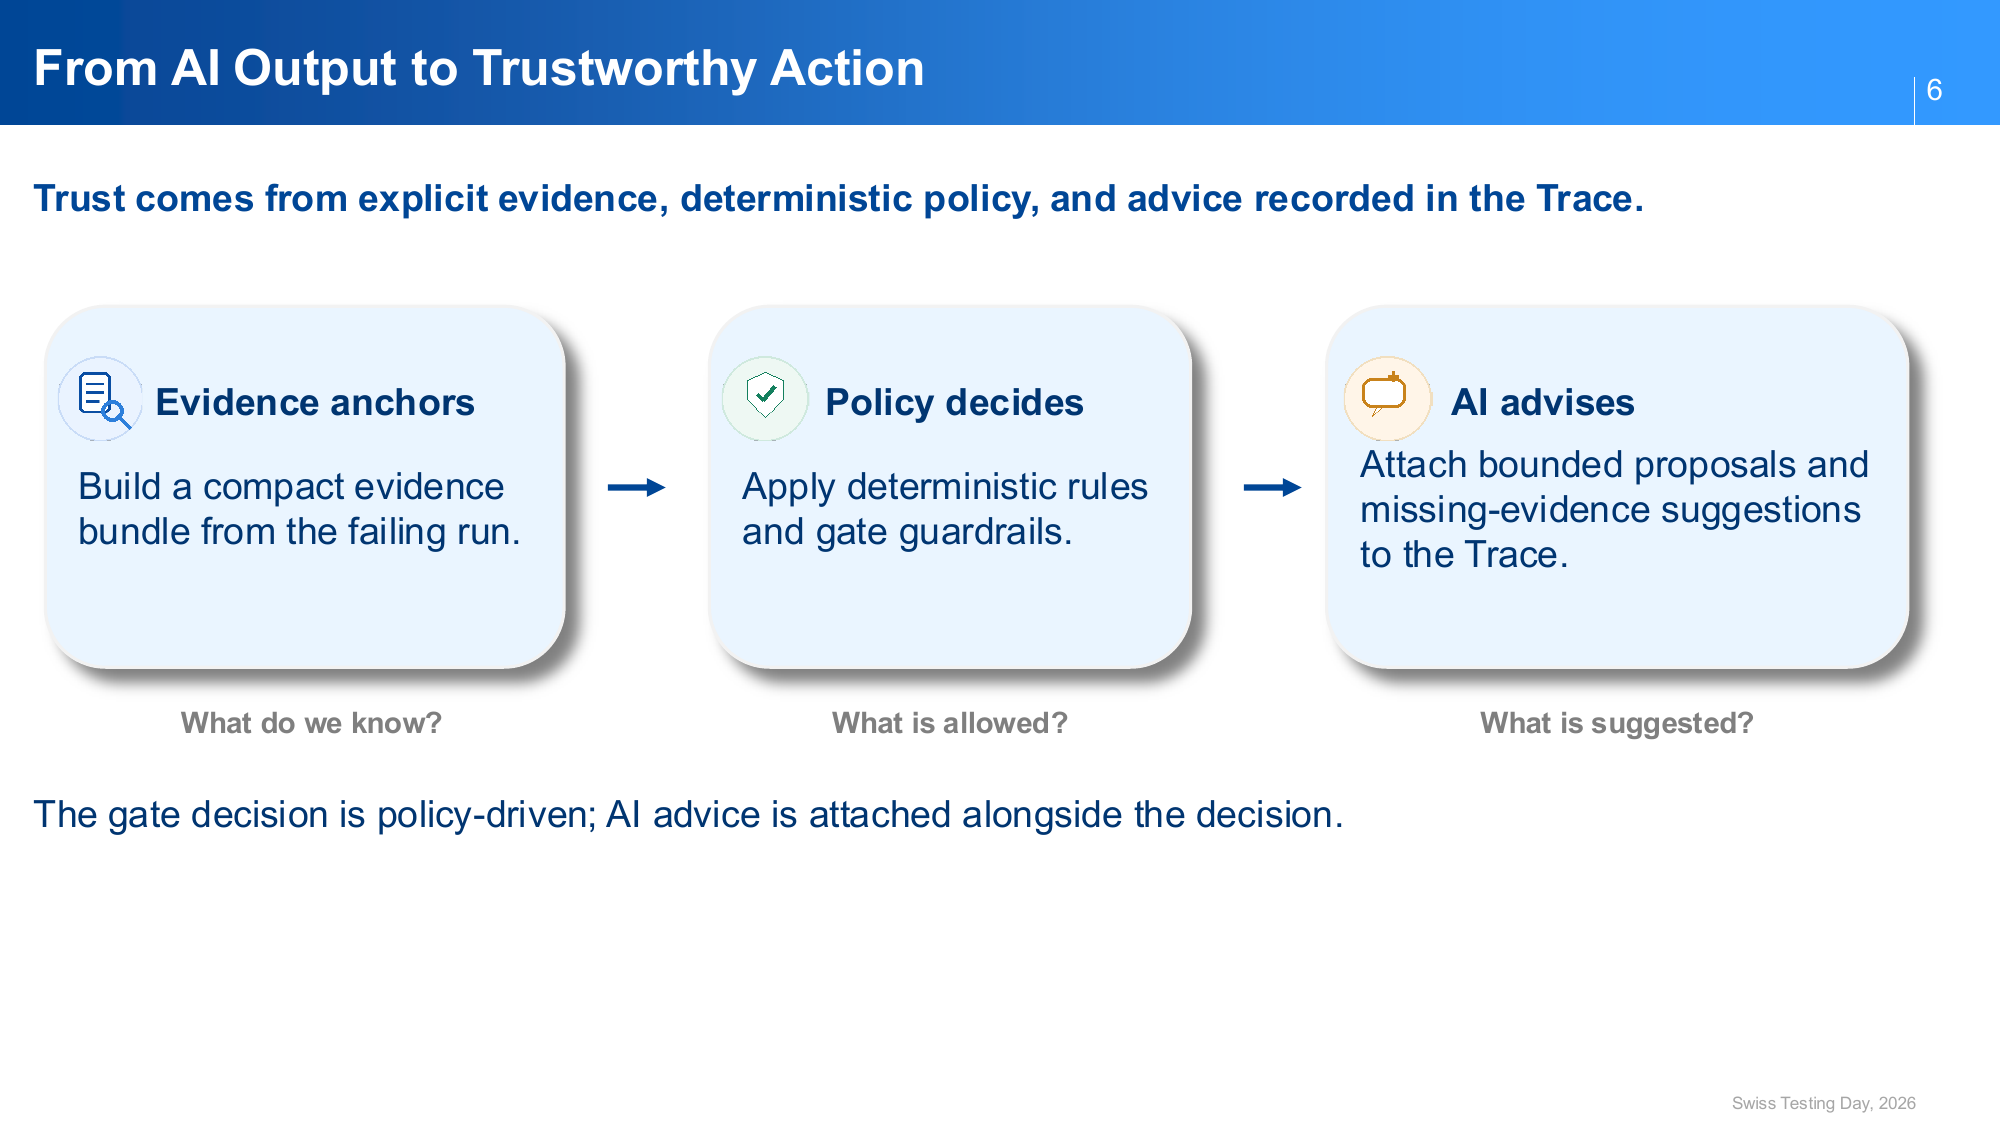
The pipeline: Evidence Anchors → Policy Gate → Bounded AI Advice. The gate decision is policy-driven and exists independently of AI.
“The gate decision is policy-driven and exists without AI. AI is there just as an advisor, attached alongside the decision.”
Risk Tiers Control AI Autonomy
-
- Low risk: Clear assertion failure, test identified, narrow scope. AI may assist (group, summarize, route tickets). No human review needed.
-
- Medium risk: Incomplete evidence (e.g., timeout with external dependency). AI may suggest, but human review is required.
-
- High risk: Missing evidence (e.g., build error without test name). AI proposals are logged, but action requires human approval.
The backbone remains constant across all tiers: explicit evidence, traceable decisions, clear ownership.
The Numbers
Berberoglu validated her approach using the public BugSwarm dataset (100 reproducible CI failure/passing pairs). The critical experiment: same AI model, different input format.
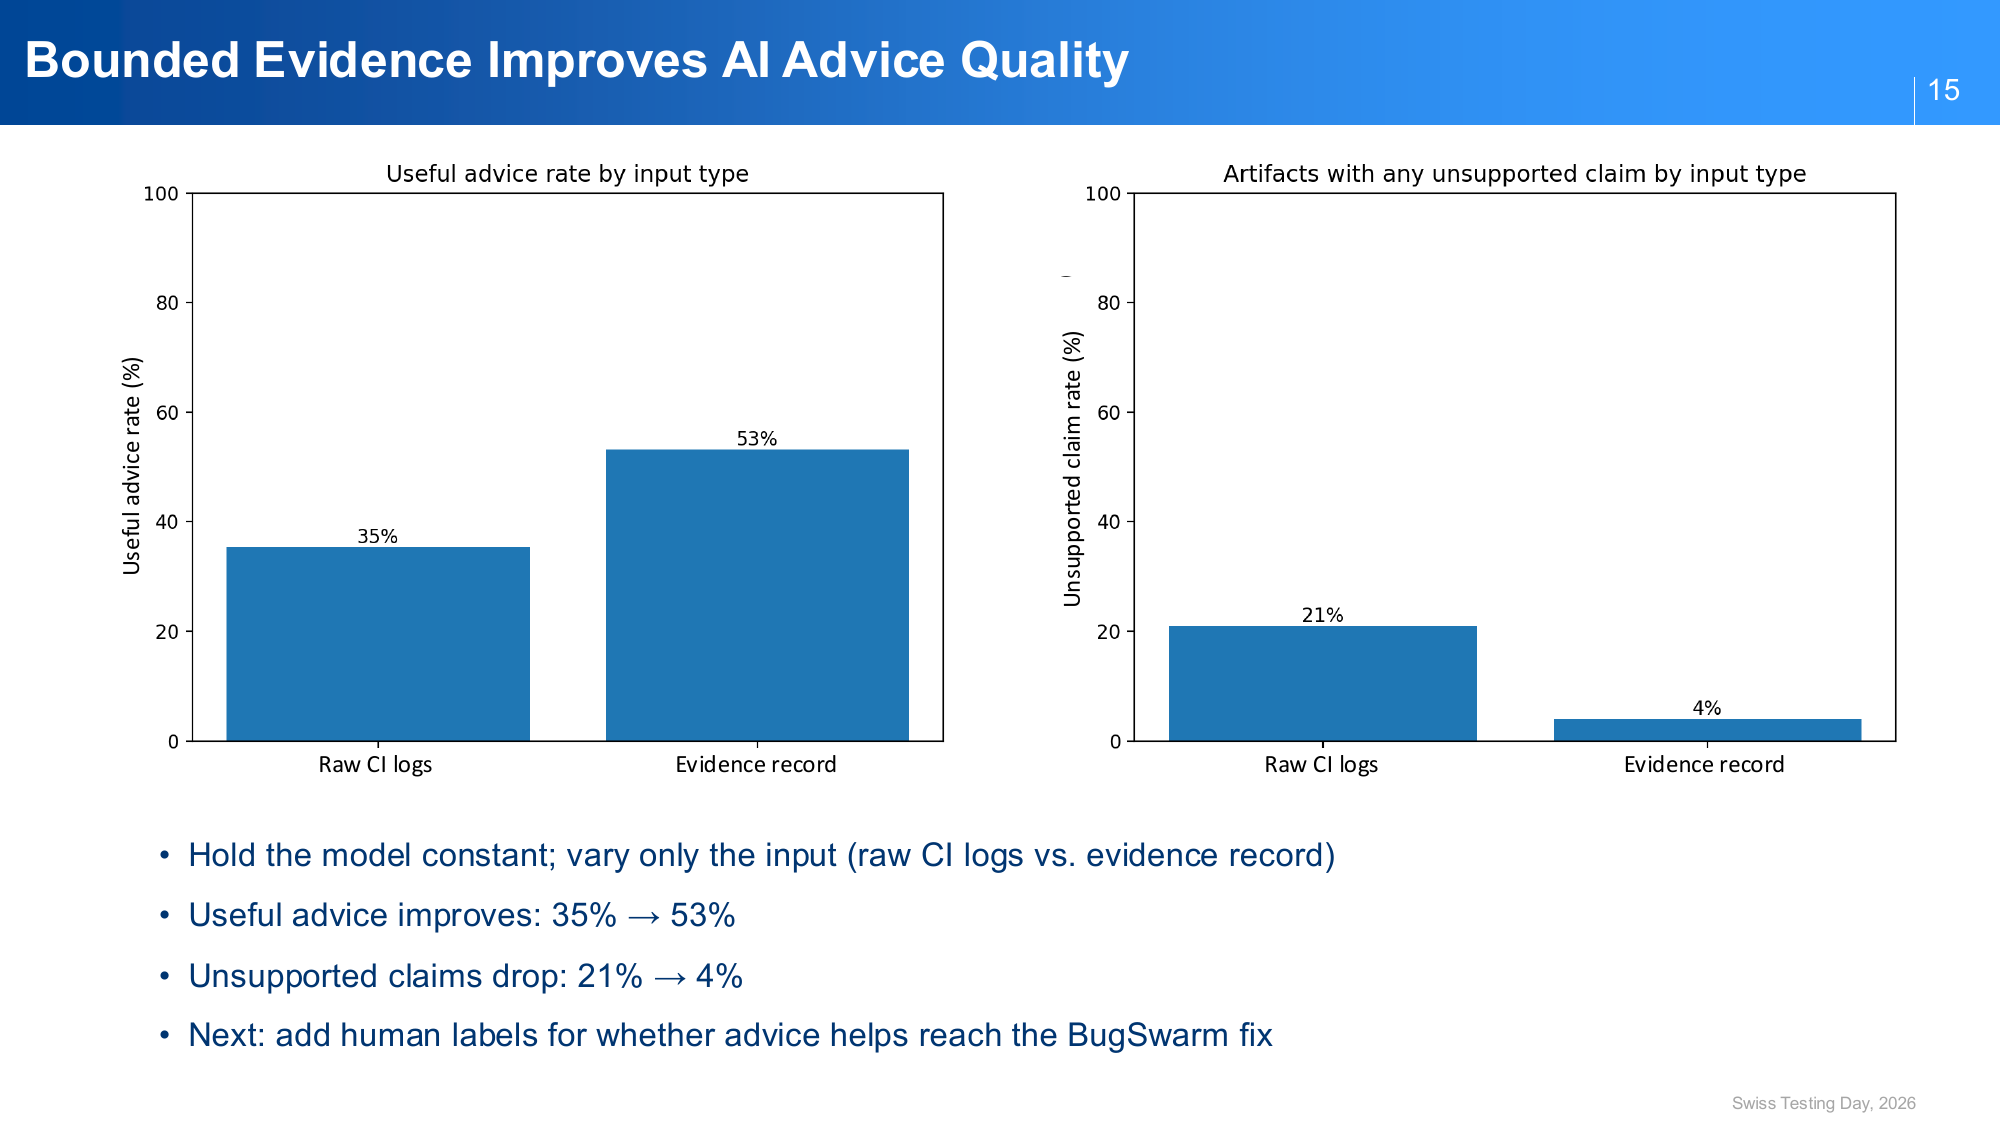
Left: Useful advice increases from 35% to 53%. Right: Unsubstantiated claims decrease from 21% to 4%.
| Metric | Raw CI Logs | Evidence Records |
|---|---|---|
| Useful advice rate | 35% | 53% |
| Unsupported claim rate | 21% | 4% |
Simply changing the input format — structured evidence records instead of raw logs — substantially improves AI quality. Raw CI logs are messy and incomplete, causing AI to “invent” information. Structured records constrain the decision space and include the gate’s risk-level context.
Challenges and Next Steps
-
- Messy logs: Extraction can fail — but missing evidence automatically triggers high risk and human review.
-
- No universal gate rules: Risk is product- and team-specific; rules need customization.
-
- Privacy: Even evidence bundles contain company data, though less than raw logs.
- Next step: A feedback loop with reviewer labels to measure whether AI suggestions actually lead to correct fixes.
Bottom Line
The approach is refreshingly pragmatic: not an AI revolution, but a classic quality management principle — evidence before action — applied to AI-assisted test analysis. The gate does not make AI obsolete; it makes AI trustworthy.
Über die Ausführung hinaus: Menschliche Überprüfung und Vertrauen in KI-gestützte Tests
Speaker: Ezgi Berberoglu (SW Engineer in Test) | Swiss Testing Day 2026 | Room 5, 10:00
Key Takeaways
- Trust, nicht Speed, ist das zentrale Problem — KI kann gleichzeitig überzeugend und falsch sein. Ohne Evidenz-Gate werden plausible Vorschläge zu riskanten Aktionen.
- Deterministische Policy Gates vor KI-Ratschlägen — Ein regelbasiertes Gate entscheidet anhand von Risiko-Stufen, ob KI handeln darf, bevor überhaupt ein KI-Vorschlag generiert wird.
- Strukturierte Evidenz verbessert KI-Qualität dramatisch — Nützliche Ratschläge steigen von 35 % auf 53 %, unbelegte Behauptungen sinken von 21 % auf 4 %, wenn statt roher CI-Logs aufbereitete Evidence Records verwendet werden.
Wenn KI-Vorschläge vertrauenswürdig werden sollen
Stellen Sie sich vor: Ein Test schlägt fehl, und die KI schlägt vor: “Wahrscheinlich flaky — quarantäne den Test, um die CI-Pipeline zu entsperren.” Klingt plausibel, macht die Pipeline grün — aber löst es das Problem? Ezgi Berberoglu, SW Engineer in Test, stellte am Swiss Testing Day 2026 einen Ansatz vor, der genau diese Frage systematisch beantwortet.
Das Kernproblem: Vertrauen statt Geschwindigkeit
“Ich interessiere mich nicht primär dafür, wie man die Ausführung beschleunigt, sondern dafür, wie man Entscheidungen bei Fehlern vertrauenswürdig macht.”
KI kann bei der Fehleranalyse enorm helfen — beim Clustern von Failures, beim Vorschlagen nächster Schritte, beim Zusammenfassen von Ergebnissen. Aber schnellere Ausgabe bedeutet nicht automatisch sicherere Entscheidungen. Das eigentliche Risiko: KI kann überzeugend und gleichzeitig falsch sein. Unter Zeitdruck nehmen Teams den KI-Vorschlag an, die Pipeline wird grün — aber die Ursache bleibt verborgen.
Die zentrale Vertrauensfrage: Klingt plausibel — aber können wir es belegen? Wer ist verantwortlich?
Die Lösung: Ein deterministisches Policy Gate
Berberoglu schlägt ein dreistufiges System vor, bei dem die KI bewusst an letzter Stelle steht:
- Evidence Anchors extrahieren — Aus den fehlgeschlagenen CI-Logs werden strukturiert Testname, Fehlertyp, Fehlermeldungen und Scope extrahiert.
- Das Gate entscheidet — Regelbasiert, ohne KI-Beteiligung. Basierend auf der Evidenzqualität und Failure-Signalen wird ein Risiko-Level zugewiesen (Low, Medium, High).
- KI berät — Erst dann kommt die KI, erhält die aufbereiteten Evidence Records (nicht die rohen Logs!) und liefert einen gebundenen Vorschlag, der dem Trace beigefügt wird.
Die Pipeline: Evidence Anchors → Policy Gate → Bounded AI Advice. Die Gate-Entscheidung ist policy-driven und existiert ohne KI.
“Die Gate-Entscheidung ist policy-getrieben und existiert ohne KI. KI ist nur als Berater dabei, angehängt an die Entscheidung.”
Risiko-Stufen bestimmen KI-Autonomie
Das Gate arbeitet mit drei Risiko-Stufen:
-
- Low Risk: Klarer Assertion-Fehler, Test identifiziert, enger Scope. KI darf assistieren (gruppieren, zusammenfassen, Tickets routen). Kein Human Review nötig.
-
- Medium Risk: Unvollständige Evidenz (z. B. Timeout mit externer Abhängigkeit). KI darf vorschlagen, aber Human Review ist erforderlich.
-
- High Risk: Fehlende Evidenz (z. B. Build-Fehler ohne Testname). KI-Vorschläge werden protokolliert, aber Aktion erfordert menschliche Genehmigung.
Unabhängig von der Risiko-Stufe gilt immer: explizite Evidenz, nachvollziehbare Entscheidungen, klare Verantwortlichkeiten.
Die Zahlen sprechen für sich
Berberoglu validierte ihren Ansatz mit dem öffentlichen BugSwarm-Datensatz (100 reproduzierbare CI-Failure/Passing-Paare). Der entscheidende Test: gleiches KI-Modell, unterschiedlicher Input.
Links: Nützliche Ratschläge steigen von 35 % auf 53 %. Rechts: Unbelegte Behauptungen sinken von 21 % auf 4 %.
| Metrik | Rohe CI-Logs | Evidence Records |
|---|---|---|
| Nützliche Ratschläge | 35 % | 53 % |
| Unbelegte Behauptungen | 21 % | 4 % |
Allein durch die Änderung des Input-Formats — strukturierte Evidence Records statt roher Logs — verbessert sich die KI-Qualität erheblich. Die Erklärung: Rohe CI-Logs sind unübersichtlich und unvollständig, was KI dazu verleitet, Informationen zu “erfinden”. Strukturierte Records grenzen den Entscheidungsraum ein.
Herausforderungen und nächste Schritte
-
- Unordentliche Logs: Extraktion kann scheitern — fehlende Evidenz führt aber automatisch zu High Risk und Human Review (“nichts Gefährliches”).
-
- Keine universellen Gate-Regeln: Risiko ist produkt- und teamspezifisch. Die Regeln müssen angepasst werden.
-
- Datenschutz: Auch Evidence Bundles enthalten Unternehmensdaten — aber weniger als rohe Logs.
-
- Nächster Schritt: Feedback-Loop mit Reviewer-Labels, um zu messen, ob KI-Vorschläge tatsächlich zum Fix führen.
Fazit
Der Ansatz ist erfrischend pragmatisch: Keine KI-Revolution, sondern ein klassisches Qualitätsmanagement-Prinzip — Evidenz vor Aktion — angewandt auf KI-gestützte Testanalyse. Das Gate macht KI nicht überflüssig, sondern vertrauenswürdig.
Über die Speakerin
Ezgi Berberoglu ist SW Engineer in Test. Ihr Fokus liegt auf der Frage, wie KI-gestützte Entscheidungen in der Testanalyse vertrauenswürdig gemacht werden können — durch evidenzbasierte Policy Gates und strukturierte Informationsaufbereitung.
Swiss Testing Day 2026 — “Defining Quality in a Dangerous Decade” — StageOne, Zürich, 26. März 2026 Berichterstattung: Xebia